[ estudo ]
Não existe ranking no ChatGPT: pergunte duas vezes e a resposta muda
Por que a palavra “ranking” não serve
Ainda é comum ver no mercado brasileiro promessas de “primeiro lugar no ChatGPT” ou de “subir no ranking das IAs”, como se a resposta de uma IA fosse a página de resultados do Google. Vale começar por aí.
No Google existe uma lista. Dez posições, uma por página, e a sua página está na 3 ou na 7. Você pode olhar hoje e amanhã e ela estará no mesmo lugar, ou perto. Faz sentido falar em ranking, em “subir posições”, em “primeira página”.
Nas IAs não existe lista. Existe um texto escrito na hora, que menciona algumas marcas e ignora o resto. Quando alguém pergunta de novo, o modelo faz uma busca nova, lê um conjunto um pouco diferente de páginas e escreve um texto diferente. A marca que apareceu primeiro na resposta das 10h pode nem aparecer na das 10h30. Não porque algo mudou no seu site, e não porque o modelo “mudou”: porque a resposta é uma amostra de uma distribuição, e amostras variam.
Isso tem uma consequência prática: um print do ChatGPT com a sua marca em primeiro não é um resultado. É uma execução. E uma promessa de “primeiro lugar no ChatGPT” é uma promessa sobre algo que não se controla.
O que o dado mostra nos EUA
Em setembro de 2026, a Suff Digital fez 300 perguntas do tipo “qual é o melhor X?” dez vezes cada, no ChatGPT (com busca) e no Gemini, com cerca de 30 minutos de intervalo. 6.000 respostas. O que saiu:
- Perguntada duas vezes seguidas, o ChatGPT nomeia uma primeira marca diferente em 56,3% das vezes. O Gemini, em 82,7%.
- Em 10 rodadas, o ChatGPT citou em média 3,7 primeiras marcas diferentespor pergunta. A marca mais frequente ficou em primeiro em 61% das respostas: o “líder” típico perde o primeiro lugar quatro vezes em dez.
- Só 8,3% das perguntas tiveram a mesma primeira marca nas 10 rodadas no ChatGPT. No Gemini, 1,3%.
- As poucas perguntas com vencedor fixo (QuickBooks para contabilidade de pequena empresa, HubSpot para CRM, Spotify para streaming) são categorias com líder consensual: reviews, rankings e guias de compra independentes apontam a mesma marca.
- Dizer “por favor”, trocar “melhor” por “top” ou errar uma letra muda quase nada (2 a 4 pontos acima da variação natural). O que muda a resposta é a intenção: acrescentar “com orçamento limitado” troca a primeira marca em 87% das vezes.
A conclusão dos autores, em uma frase: visibilidade no ChatGPT não é um ranking que você ocupa; é uma fatia de respostas que você ganha.
O que o dado mostra no Brasil
Para ver se o mesmo vale aqui, olhamos a base da Dolomite AI: mais de 30 mil respostas de ChatGPT, Gemini, Perplexity e Google AI Overviews a perguntas de compra em português, com cada pergunta repetida dezenas de vezes ao longo de 60 dias (de meados de agosto a meados de outubro de 2026). O detalhe está na metodologia, no fim.
Medimos duas coisas em cada resposta. Presença: a marca aparece ou não. Primeira citada: a marca é a primeira da lista de marcas que o modelo citou, a mesma métrica da Suff.
A primeira marca citada quase nunca fica parada
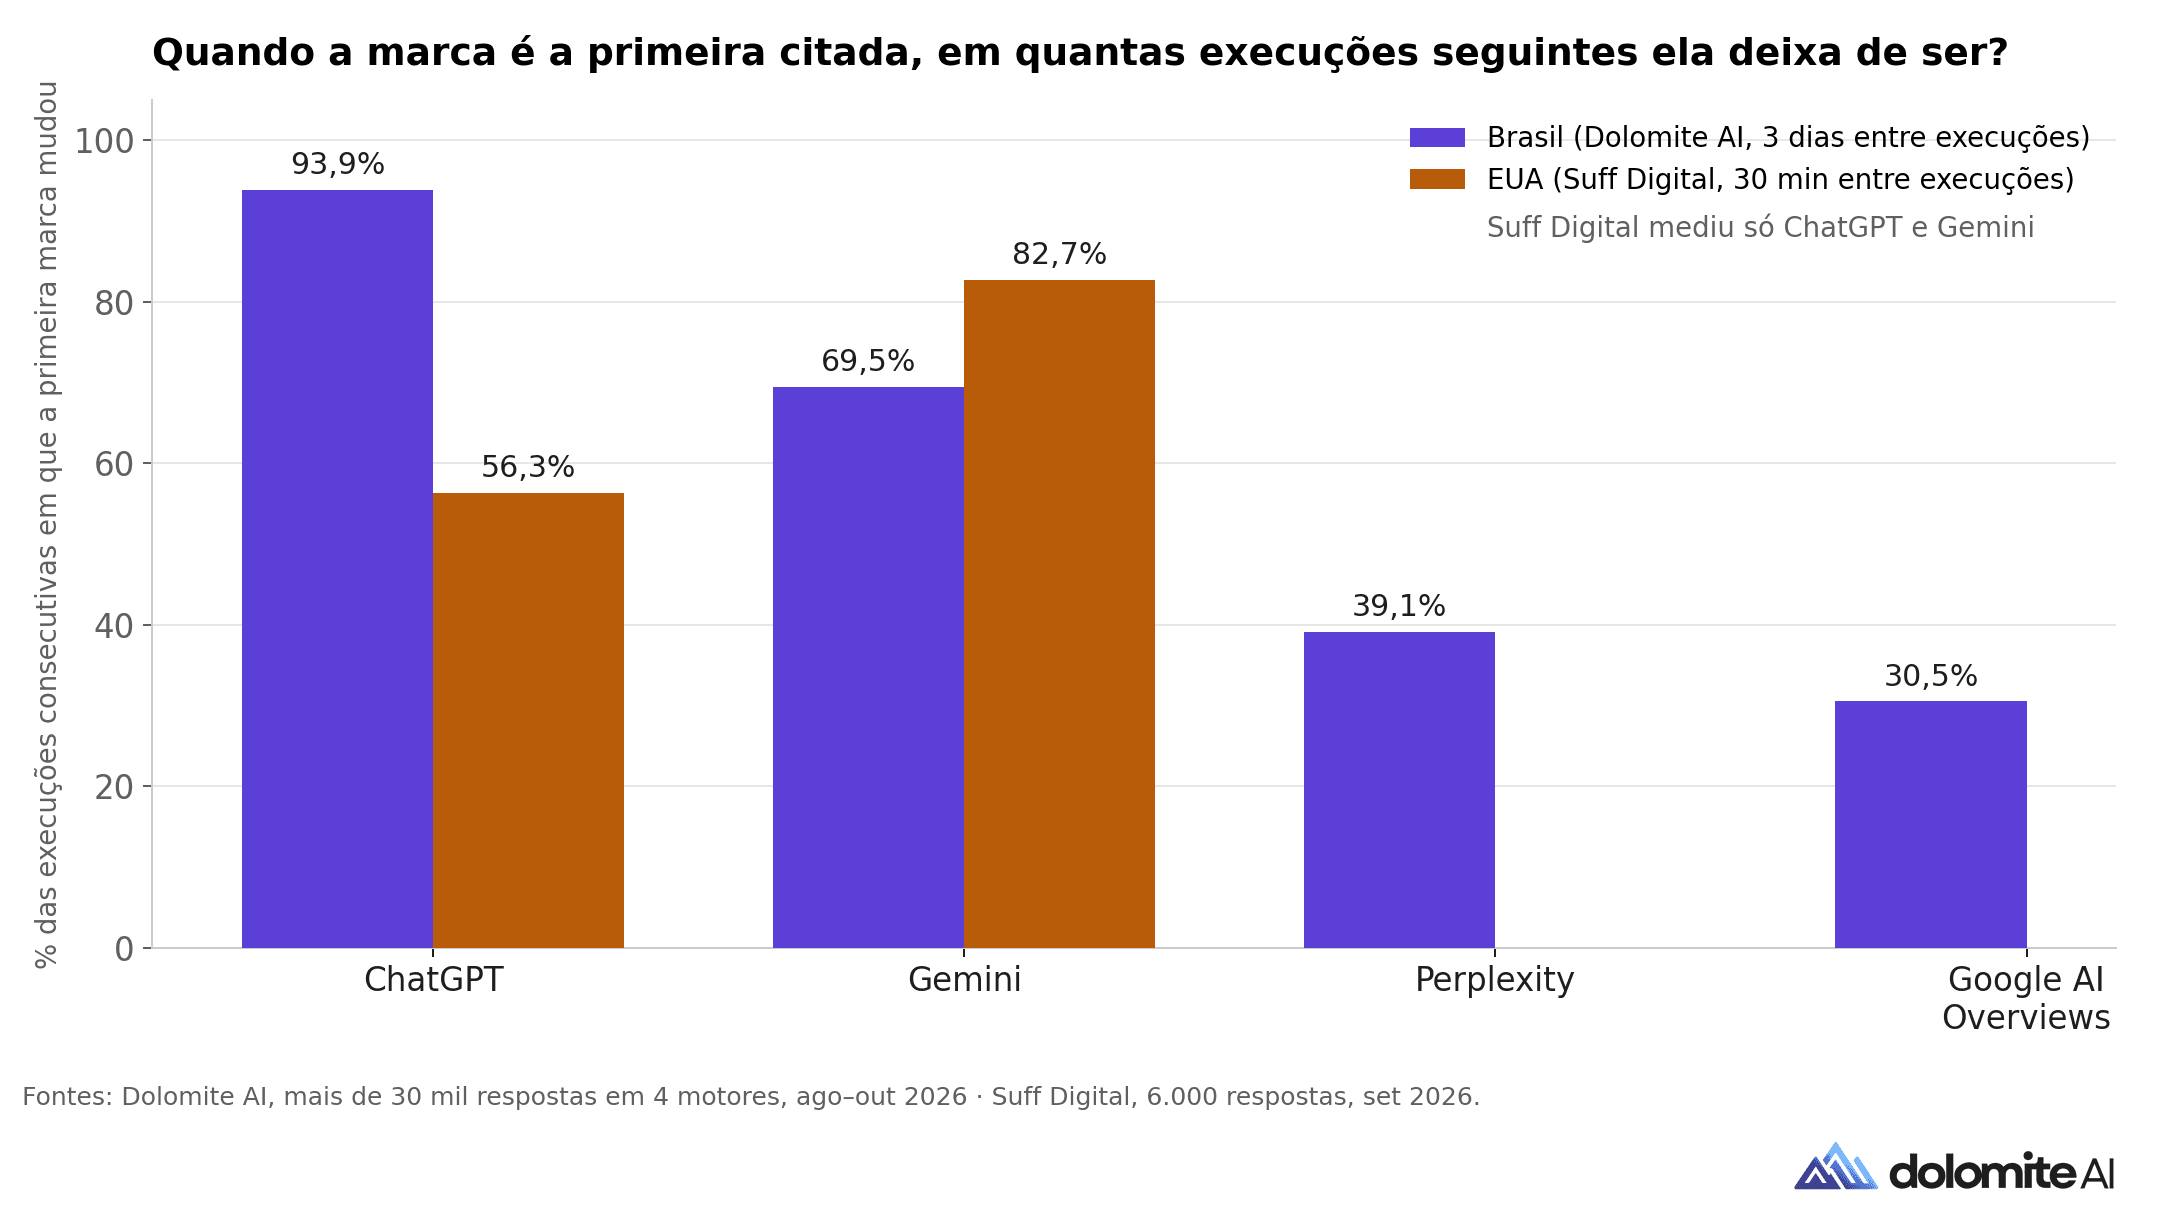
| Motor | Quando a marca é a primeira citada, deixa de ser na execução seguinte em | Perguntas em que a marca foi a primeira em todas as execuções |
|---|---|---|
| ChatGPT | 93,9% | nenhuma |
| Gemini | 69,5% | nenhuma |
| Perplexity | 39,1% | 3,7% |
| Google AI Overviews | 30,5% | 16,7% |
No ChatGPT, cerca de um quarto das perguntas teve a marca como primeira citada em alguma execução. Nenhuma a manteve em todas. Quando acontece, acontece em média em 7% das execuções daquela pergunta. No Gemini, também nenhuma. Nos dois, não existe “primeiro lugar” estável para nenhuma marca, em nenhuma das perguntas.
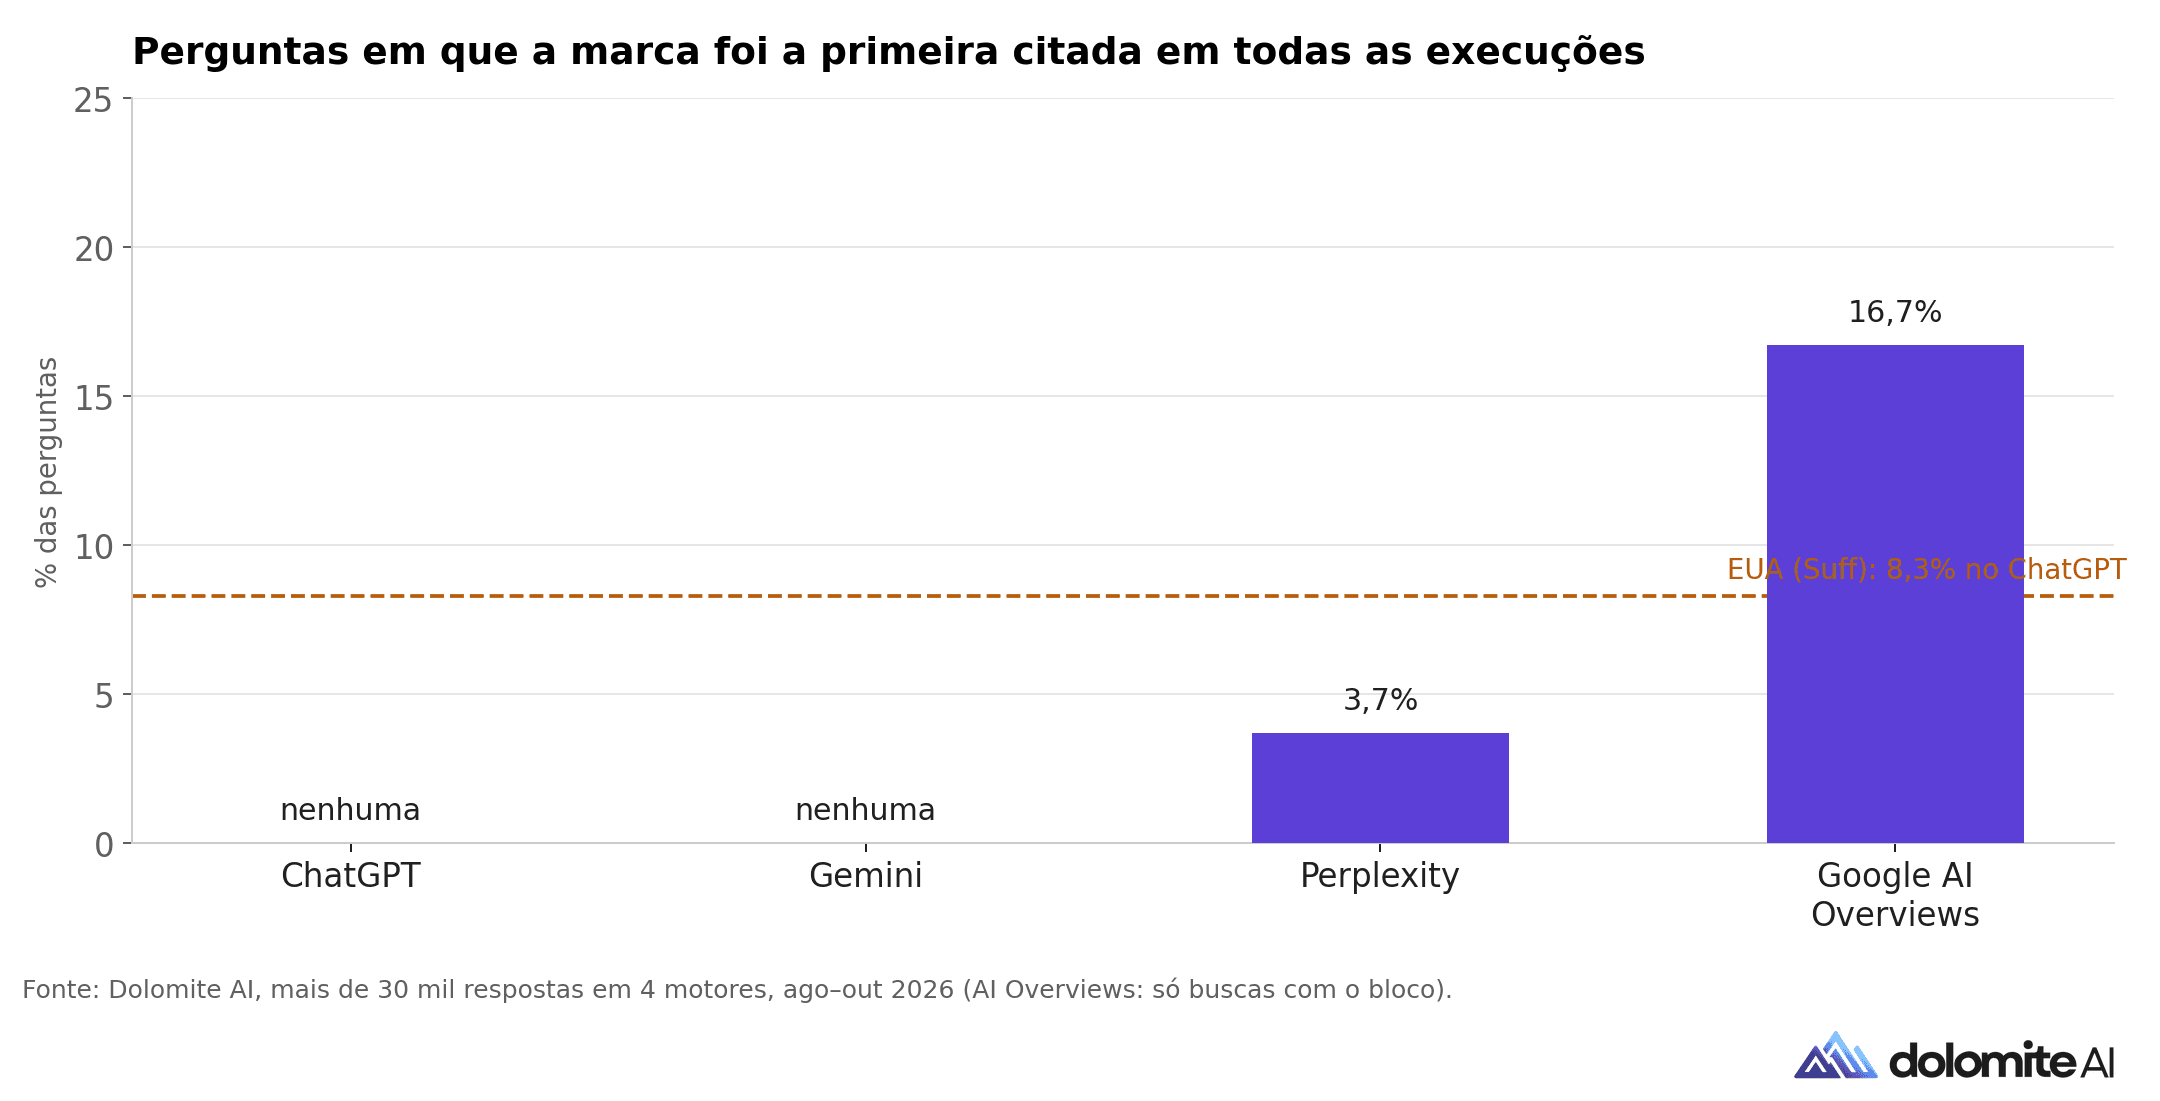
No Perplexity e no AI Overviews existe um grupo de perguntas com primeira citada fixa: 4% e 17%. São as categorias com líder consensual, o mesmo padrão que a Suff viu com QuickBooks e HubSpot. O AI Overviews, por ser montado sobre o índice do Google, é o mais estável dos quatro; ainda assim, em 83% das perguntas a primeira marca roda.
A presença também varia, mas menos
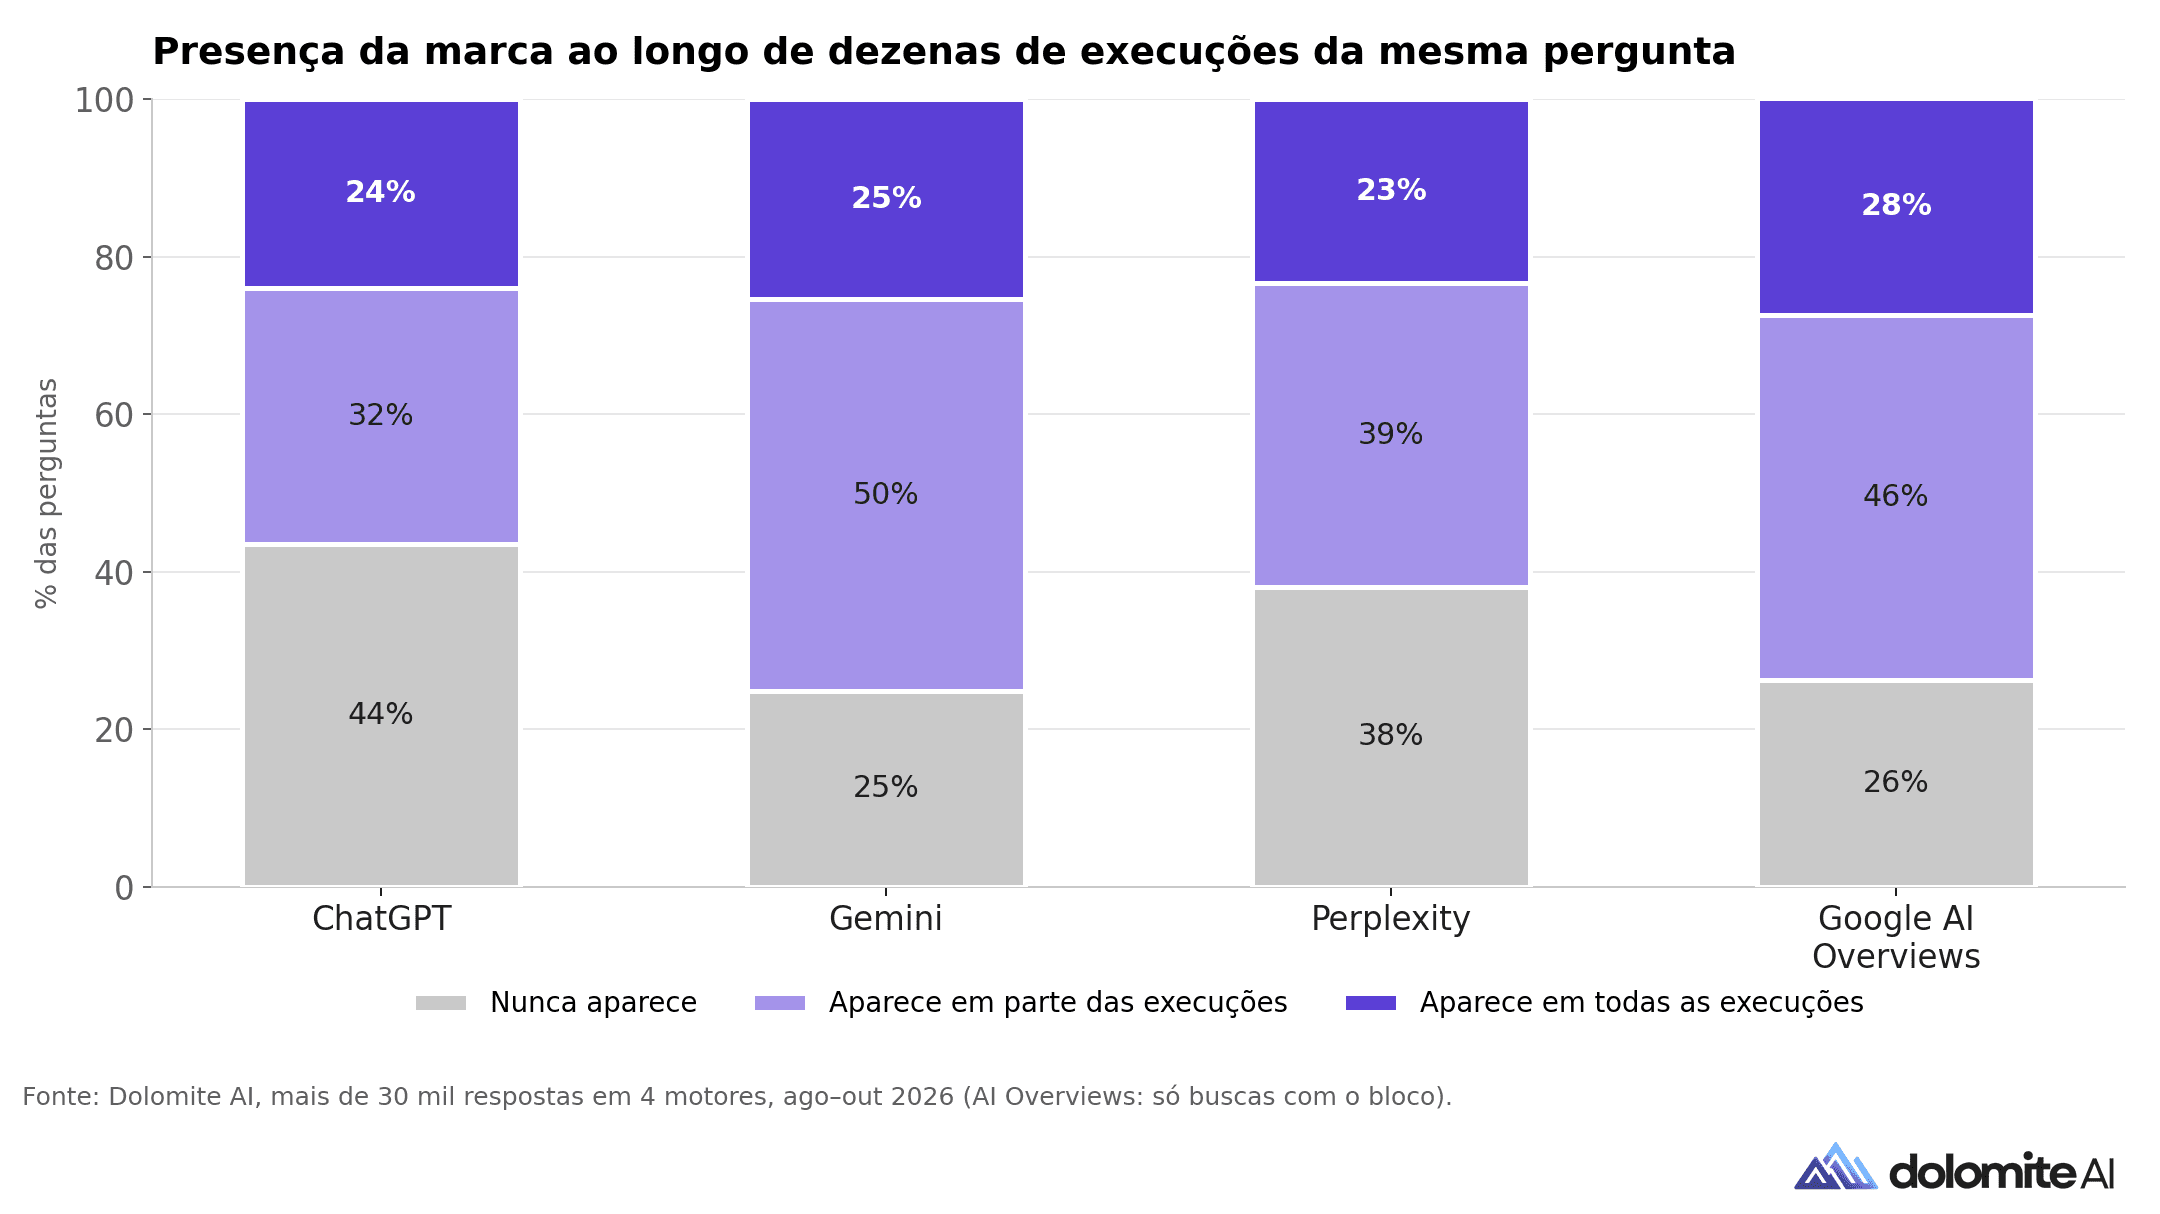
| Motor | Marca nunca aparece | Marca oscila | Marca aparece em todas as execuções | Presença muda entre execuções consecutivas (onde a marca aparece) |
|---|---|---|---|---|
| ChatGPT | 43,5% | 32,5% | 24,0% | 21,1% |
| Gemini | 24,8% | 49,8% | 25,4% | 25,4% |
| Perplexity | 38,0% | 38,6% | 23,4% | 23,8% |
| Google AI Overviews | 26,2% | 46,4% | 27,5% | 24,0% |
Um quarto das perguntas tem a marca presente em 100% das execuções, nos quatro motores. Isso é conquistável: é o que acontece quando a marca está no vocabulário do modelo e tem página citável para a pergunta. Nas demais perguntas em que a marca aparece, ela entra ou sai da resposta em 1 de cada 4 ou 5 execuções.
Entre “aparecer sempre” e “ser a primeira sempre” há uma distância que nenhum trabalho de AEO fecha, porque a segunda não depende só de você.
Por que acompanhar, então
Se a resposta varia, medir uma vez não serve. Mas é exatamente por variar que acompanhar importa:
- As respostas seguem uma distribuição probabilística. Para a mesma pergunta, a marca aparece em uma fração das execuções, e essa fração é o número real.
- A sua marca pode ser mencionada quando você pergunta e não ser quando outra pessoa pergunta. Não porque o modelo mudou entre uma e outra; porque cada resposta é um sorteio dentro dessa distribuição.
- Acompanhar é perguntar a mesma pergunta muitas vezes, em vários motores, ao longo do tempo. Quanto mais execuções, mais fiel a visão da distribuição.
- O que muda com trabalho de AEO é a distribuição, não uma execução. Uma marca que sai de 30% para 60% de presença numa pergunta fez AEO. Uma que “ficou em primeiro” num print fez um print.
Uma comparação de duas execuções, antes e depois de uma mudança, é ruído, a menos que a diferença seja maior que a variação natural (que, como vimos, é de 20% a 25% só na presença). O que diz algo é a série: N execuções por pergunta, por motor, ao longo de semanas. O método está em ciclos e amostragem, e as formas de medir, da manual à plataforma, em como saber se sua marca aparece no ChatGPT.
Por que algumas marcas parecem “sempre em primeiro”
Quem testa a própria marca e a vê em primeiro três vezes seguidas conclui que existe ranking. O que existe é um líder consensual numa categoria pequena: uma marca que o modelo já conhece pelo nome, que tem páginas respondendo às perguntas da jornada, e que aparece nas listas e comparativos que a IA consulta. Nesse cenário a frequência de primeira posição é alta, 60%, 70%, às vezes mais. Mas é frequência. Na quarta ou quinta execução, outra marca entra. Os dados americanos mostram isso: mesmo com líderes como QuickBooks e HubSpot, só 8% das perguntas tiveram a mesma primeira marca em todas as rodadas.
Categoria concorrida, com várias marcas parecidas (tênis de corrida, aspirador de pó, cadeira de escritório), é rodízio. O líder ganha mais rodadas; não ganha todas.
O que dá para prometer, e o que não dá
Não dá:“sua marca em primeiro lugar no ChatGPT”. Não existe posição; existe distribuição. Quem promete está prometendo controlar a variação de um modelo que gera cada resposta do zero.
Dá: subir a frequência. Em quantas das N execuções a marca aparece (presença), em quantas é a primeira citada, e qual a fatia dela entre as marcas citadas (share of voice). Esses números se medem, se comparam mês a mês e respondem a trabalho: estar no vocabulário do modelo (consistência de entidade), ter página que responde à pergunta (conteúdo), estar nas fontes que a IA consulta (terceiros).
Metodologia
Base da Dolomite AI: marcas brasileiras de consumo, de segmentos diferentes, com centenas de perguntas da jornada de compra em português, cada uma executada dezenas de vezes em ChatGPT, Gemini, Perplexity e Google AI Overviews, em ciclos de três dias, entre meados de agosto e meados de outubro de 2026: mais de 30 mil respostas no total. Só entraram perguntas com cinco ou mais execuções por motor. Presença: a marca aparece na resposta. Primeira citada: a marca é a primeira da lista de marcas que o próprio modelo declarou ter citado, na ordem em que aparecem no texto. “Muda entre execuções consecutivas” compara cada execução com a seguinte do mesmo par pergunta-motor. No AI Overviews, buscas em que o bloco não apareceu foram excluídas. Falhas de leitura da resposta são registradas como ausência, portanto a presença real é igual ou maior que a medida. Marcas anonimizadas.
Perguntas frequentes
Então não adianta fazer nada, já que a resposta varia?
Adianta, mas o alvo é outro. Você não controla qual marca o ChatGPT cita numa resposta específica; controla a probabilidade de ser citado em muitas. Presença estável em 100% das execuções existe em um quarto das perguntas da nossa base. É resultado de trabalho, não de sorte.
Por que minha marca aparece em primeiro quando eu testo?
Provavelmente porque você é o líder consensual da sua categoria, e a frequência de primeira posição é alta. Teste dez vezes, em janela anônima, em dias diferentes, e conte. Se der 7 em 10, você tem 70%, não "primeiro lugar". É um ótimo número, e é um número.
Uma agência pode garantir primeiro lugar no ChatGPT?
Não. Pode garantir trabalho que aumenta a frequência de menção. Qualquer garantia de posição numa resposta gerada na hora é uma promessa sobre algo que ninguém fora da OpenAI controla.
Qual IA é mais estável?
Na nossa base, a primeira marca citada é mais instável no ChatGPT (muda em 94% das execuções consecutivas) e no Gemini (70%), e menos no AI Overviews (31%) e no Perplexity (39%). A presença varia parecido nos quatro, entre 21% e 25%. Nos dados americanos, o Gemini troca o primeiro lugar mais que o ChatGPT (83% contra 56%).
Qual a diferença entre o estudo americano e o nosso?
A Suff mediu a primeira marca citada com 30 minutos entre execuções, em 300 perguntas em inglês, em dois motores. Nós medimos presença e primeira marca citada com 3 dias entre execuções, em centenas de perguntas em português, em quatro motores. A métrica de primeira citada é a mesma; o intervalo e o mercado são outros. As duas bases mostram que a resposta não é fixa.
Como a Dolomite AI mede isso?
Cada pergunta roda várias vezes por motor, em ciclos, e a plataforma registra em cada execução se a marca apareceu, em que posição entre as marcas citadas e quais concorrentes vieram. O que você vê é a série, não a foto: presença e share of voice ao longo do tempo. Veja visibilidade e share of voice em IA.